Automatisierungsausfall: Ersatzprozess planen
So planen Unternehmen Erkennung, Meldung, Verantwortung und manuellen Weiterbetrieb, wenn eine Automatisierung ausfällt.
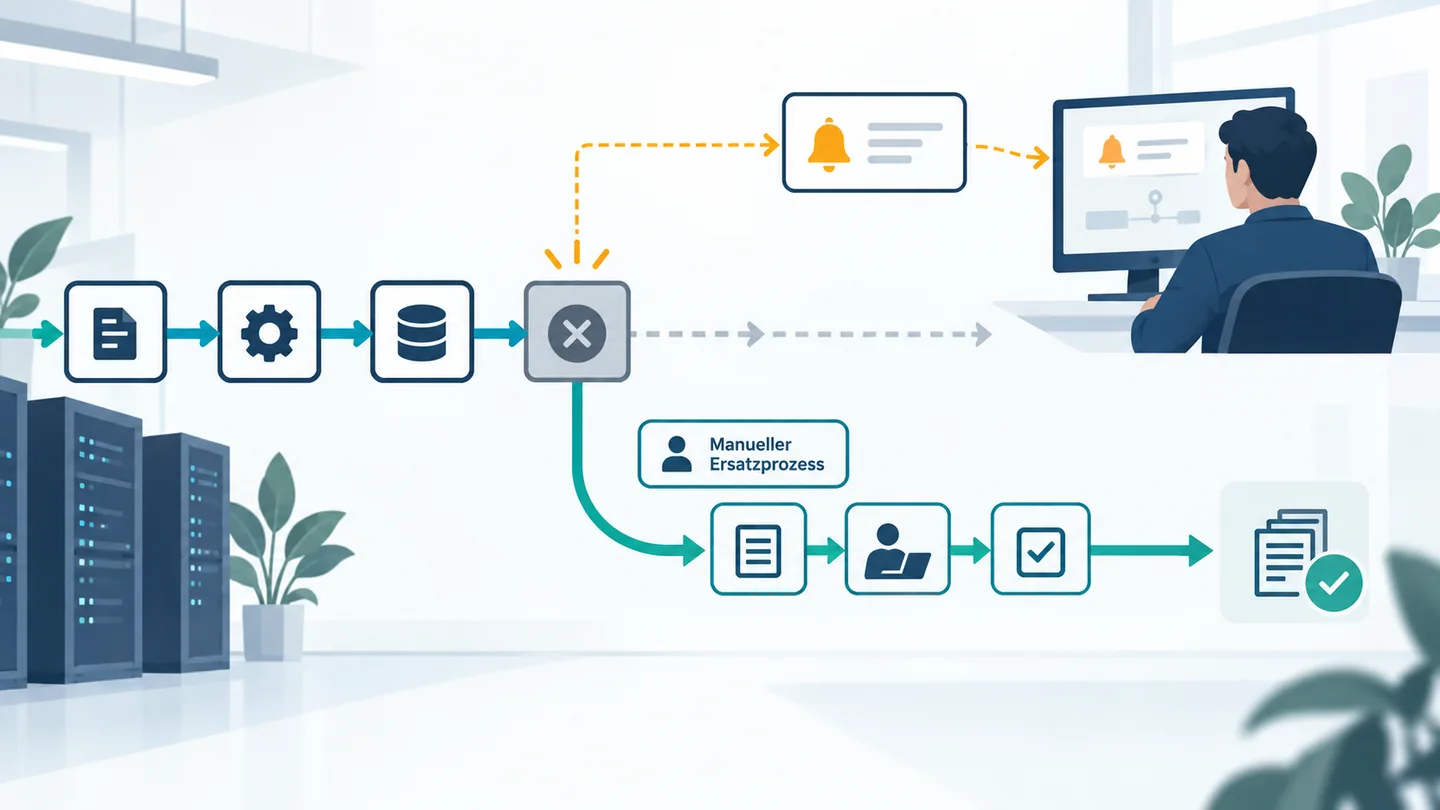
Eine Automatisierung kann technisch laufen und fachlich trotzdem falsche Ergebnisse liefern. Sie kann auch ganz stoppen, weil ein Zugang abläuft, eine Schnittstelle ihr Format ändert oder ein Zielsystem nicht erreichbar ist. Monitoring muss deshalb mehr prüfen als „Workflow gestartet“.
Planen Sie vor dem Start, wie ein Fehler erkannt wird, wer ihn bearbeitet und wie der wichtigste Prozess vorübergehend manuell weiterläuft. Der Ersatzprozess ist Teil der Lösung, kein Zeichen für eine gescheiterte Automatisierung.
Fehlerarten getrennt betrachten
| Fehlerart | Beispiel | Geeignetes Signal |
|---|---|---|
| technischer Abbruch | API nicht erreichbar | fehlgeschlagener Lauf mit Fehlercode |
| fachlicher Fehler | Anfrage falsch zugeordnet | Kontrollprobe oder Korrekturquote |
| stiller Stillstand | Zugang abgelaufen, keine neuen Läufe | erwarteter Eingang fehlt |
| Teilfehler | Datensatz erstellt, E-Mail nicht gesendet | Status je Prozessschritt |
| Mehrfachverarbeitung | derselbe Eingang zweimal gebucht | eindeutige Vorgangskennung |
| Verzögerung | Warteschlange wächst | Alter des ältesten offenen Vorgangs |
Nicht jeder Fehler braucht denselben Alarm. Ein vorübergehender zweiter Versuch kann automatisch erfolgen. Wiederholte Fehler, verlorene Eingänge oder falsche externe Aktionen brauchen eine verantwortliche Person.
Monitoring vom Geschäftsergebnis her planen
Definieren Sie für jeden kritischen Schritt ein erwartetes Ergebnis. Bei einer Anfrageverteilung ist nicht nur der Start des Workflows relevant, sondern auch ein gespeicherter Vorgang mit Zuständigkeit. Bei einem Dokumentenexport zählen lesbare Datei und erwarteter Speicherort.
Das NIST beschreibt in SP 800-61 Revision 3 Vorbereitung, Erkennung, Reaktion und Wiederherstellung als Bestandteile eines wirksamen Incident-Response-Ansatzes. Der Leitfaden richtet sich an Cybersicherheitsvorfälle; für betriebliche Automatisierung wird hier nur das übertragbare Prinzip genutzt, Fehlerreaktion und Wiederanlauf vorab zu organisieren.
Protokollieren Sie mindestens Zeitpunkt, Vorgang, erreichten Schritt, Fehlerklasse und nächsten Versuch. Speichern Sie keine vollständigen Nachrichten oder personenbezogenen Inhalte, wenn für Diagnose und Zuordnung eine technische Kennung genügt.
Alarm braucht Empfänger und Handlung
Eine Meldung ohne Besitzer bleibt leicht liegen. Legen Sie pro Fehlerklasse fest:
- Wer erhält die erste Meldung?
- Welche Information wird zur Prüfung benötigt?
- Wann reicht ein erneuter Versuch?
- Wann wird der Prozess gestoppt?
- Wer informiert betroffene interne Stellen?
- Wo wird der Status dokumentiert?
Vermeiden Sie Warnungen bei jedem normalen Sonderfall. Zu viele unwichtige Meldungen verdecken kritische Fehler. Fassen Sie wiederkehrende Hinweise zusammen und eskalieren Sie, wenn Zahl oder Dauer eine vereinbarte Grenze überschreitet.
Schwellen aus dem Prozess ableiten
Eine feste Alarmzahl passt nicht zu jedem Ablauf. Bei seltenen, aber zeitkritischen Eingängen kann schon ein einzelner fehlender Vorgang wichtig sein. Bei häufigen, unkritischen Importen kann eine gebündelte Meldung genügen. Definieren Sie Schwellen daher über Geschäftswirkung, erwartete Häufigkeit und maximal vertretbare Verzögerung. Dokumentieren Sie, wer diese Annahmen überprüft, wenn Volumen oder Prozess sich ändern.
Manuellen Ersatzprozess konkret beschreiben
Das BSI beschreibt Business Continuity als anpassbare Methodik, um den Geschäftsbetrieb bei Notfällen und Krisen fortzuführen und wiederherzustellen. Für einen kleinen Workflow darf der Ersatzprozess deutlich schlanker sein, sollte aber dieselben Kernfragen beantworten:
- Wie werden neue Eingänge während des Ausfalls erkannt?
- Wo wird eine manuelle Arbeitsliste geführt?
- Wer übernimmt Bearbeitung und Priorisierung?
- Wie werden doppelte Vorgänge beim Wiederanlauf vermieden?
- Wie gelangen manuell bearbeitete Fälle zurück in den normalen Stand?
Der Ersatzweg sollte ohne das ausgefallene System funktionieren. Liegen Anleitung und Kontaktliste ausschließlich darin, sind sie im Störungsfall nicht erreichbar.
Fehlerfall: Wiederanlauf erzeugt doppelte Vorgänge
Eine Schnittstelle fällt mehrere Stunden aus. Mitarbeitende übertragen wichtige Anfragen manuell. Nach der Reparatur verarbeitet die Automatisierung alle wartenden Eingänge erneut und legt dieselben Vorgänge ein zweites Mal an.
Verhindern lässt sich das durch eindeutige Eingangskennungen und einen dokumentierten Abgleich. Vor dem Wiederanlauf wird festgelegt, welche Vorgänge bereits manuell übernommen wurden. Die Automatisierung erkennt sie oder stellt die Warteschlange zunächst zur Kontrolle bereit. Ein pauschales „alles noch einmal starten“ ist kein sicherer Wiederanlauf.
Abnahme und regelmäßige Probe
Testen Sie nicht mit echten Kundenfällen. Simulieren Sie einen nicht erreichbaren Dienst, ungültige Daten, doppelten Eingang und ausbleibende Ausführung. Prüfen Sie, ob Alarm, Zuständigkeit, Fehlerablage und manueller Weg tatsächlich funktionieren.
- Ist der fachliche Erfolg eines Laufs erkennbar?
- Werden Teilfehler und stille Stillstände entdeckt?
- Enthält eine Meldung genug Kontext ohne unnötige Daten?
- Kann die zuständige Person den Ersatzprozess starten?
- Werden manuelle Fälle beim Wiederanlauf berücksichtigt?
- Gibt es einen Abschlussvermerk und eine Ursachenanalyse?
Der Ratgeber Kundenanfragen automatisieren zeigt diese Fragen am Anfrageprozess. KDS plant individuelle Abläufe unter Automatisierung. Für eine schriftliche Einordnung können Sie Auslöser, Zielsystem und kritischsten Ausfallfall senden.